Cerebro empresarial: cómo activar lo que ya sabe tu empresa
Un caso real de gestión del conocimiento corporativo: cómo estructuramos la documentación técnica y el conocimiento tácito de una empresa de oftalmología y microcirugía en tres capas (RAW, WIKI, SCHEMA) para crear un cerebro vivo que cualquier IA puede consultar.
Hace unos meses empezamos un proyecto para una empresa que quería que su equipo pudiera preguntar sobre productos, procedimientos y conocimiento comercial a su IA, y obtener respuestas fiables.
Documentación hay de sobra. Catálogos, presentaciones, publicaciones científicas, fichas técnicas, manuales, archivo histórico. El patrimonio que cualquier empresa acumula mientras sigue funcionando gracias al método más eficaz que existe hasta que falla: preguntarle a la persona que sabe dónde mirar.
Podíamos haber cargado los casi 100 documentos originales, conectado una IA y celebrado lo rápido que encontraba las cosas. Ya contamos por qué eso es un error: el problema de la IA empresarial casi nunca está en la tecnología; más bien suele tratarse de que esa tecnología entienda el negocio con la precisión suficiente para resultar fiable y segura. Preguntar a los documentos no basta porque una IA puede perfectamente fundir dos productos que comparten familia comercial, convertir una comparación interna en una afirmación técnica, o inventar con un aplomo que ya conocemos bien, camuflando el error para que no lo parezca.
Antes de decirle dónde buscar o siquiera qué buscar, había que enseñarle qué estaba leyendo, con qué autoridad, y para qué.
Tres capas, una regla: la verdad no se toca
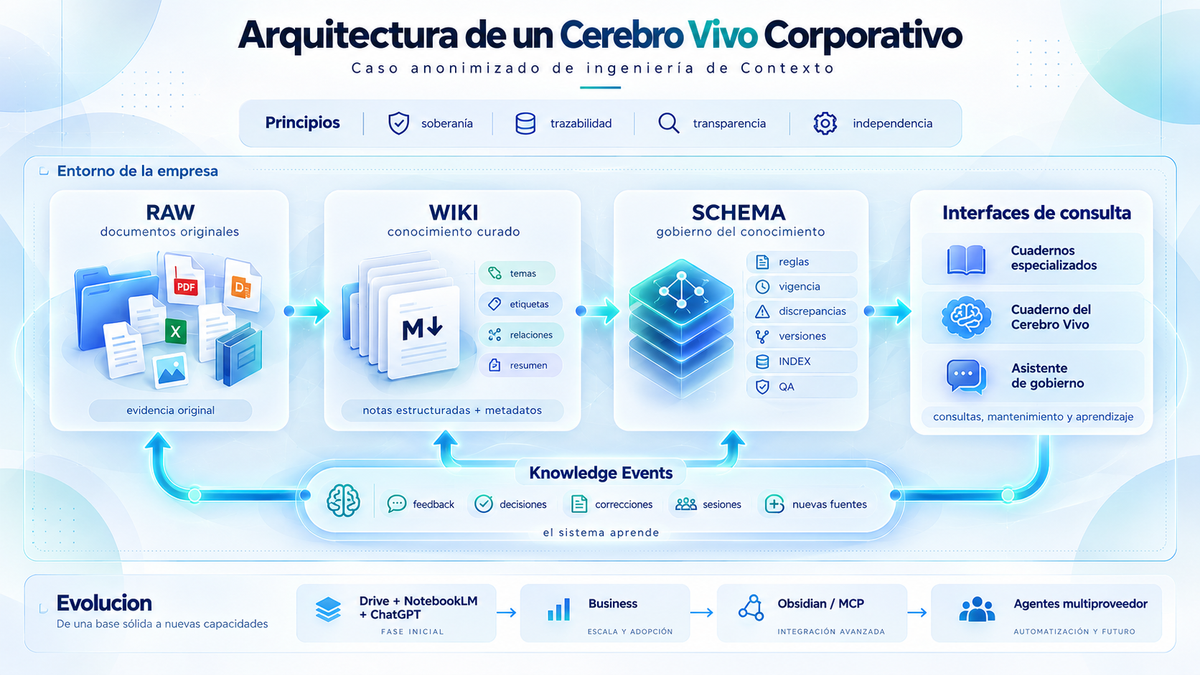
Diseñamos el sistema con la arquitectura de tres capas que describió Andrej Karpathy: Raw, Wiki y Schema.
Raw es el perímetro intacto de los documentos originales. Nadie los edita, ni siquiera nosotros. Cuando algo suena raro, esta capa responde a la única pregunta que importa: ¿esto de dónde sale?
Wiki traduce esos documentos, que se hicieron pensando que los leería e interpretaría una persona, en notas curadas con metadatos: procedencia, vigencia, entidades, relación con otras notas. Un PDF de cuarenta páginas puede convertirse en varias notas si habla de varios productos. En esta fase se hace ingeniería de contexto, es como montar una refinería de conocimiento.
Schema es la capa en la que una empresa escribe sus propias reglas: qué fuente tiene más autoridad, qué significa que algo esté pendiente de validar, cómo se versiona una corrección. Quedan registradas también las discrepancias que aparecen al curar, por ejemplo una nomenclatura obsoleta, un producto sustituido, una práctica comercial en desuso reflejada en documentos que sin embargo contienen otras cosas útiles, y así.
Por fases, y no de golpe
Lo primero un piloto, para comprobar que las piezas encajaban. Luego una primera versión con tres cuadernos curados por área (Gestión comercial, Microcirugía y Oftalmología) construido cada uno desde las fuentes de su propio dominio. Y una segunda versión cuyo proceso consistió en:
- Una auditoría de cuánta información original quedó realmente traducida a la capa Wiki.
- Un índice global de curación embebido en los routers.
- Un catálogo de discrepancias a resolver por el cliente.
- Routers entre cuadernos con instrucciones de comportamiento propias de cada área.
- Un banco de pruebas de calidad.
- Un cuaderno "de instrucciones" que documenta el propio sistema: cómo se usa, cómo se mantiene y cómo puede evolucionar.
¿Y si se pierden las conversaciones? Aunque casi nadie lo pregunta...
Ya hemos hablado de la amnesia que sufre la IA respecto al conocimiento que no se repite lo suficiente. A otra escala, dentro de una empresa pasa algo parecido: alguien tiene una conversación estupenda con la IA, llega a una conclusión útil, cierra la pestaña, y esa conclusión se pierde. Así que al acabar añadimos una pieza más: al cierre de cada sesión, se invita al usuario a generar un informe para que los responsables del cerebro sepan cómo se está usando de verdad, sin suposiciones. Aquí el sistema captura lo que llamamos knowledge events: una corrección, una decisión, una observación de un experto. Antes de darlos por buenos, se revisan y luego, si corresponde, pasa a formar parte de la memoria real.
La tecnología costó casi nada, el trabajo estaba en otra parte
Toda la infraestructura del proyecto consistió en una licencia de ChatGPT Plus y una cuenta gratuita de Google Drive con NotebookLM del propio cliente. Nada más.
El coste estuvo en leer bien, decidir qué significa cada cosa, detectar huecos, diseñar un método repetible y de fácil mantenimiento incluso sin nuestra ayuda. Si el sistema demuestra valor, ya habrá tiempo de industrializarlo. No hace falta construir una central nuclear para calentar un café.
Esa disciplina se puso pronto a prueba: uno de los cuadernos se acercó al límite de fuentes que permite NotebookLM. La pregunta que tuvimos que responder fue arquitectónica: ¿qué hacemos cuando el conocimiento ya no cabe en la herramienta? La respuesta fijó un principio del sistema: el cerebro pertenece a la empresa, NotebookLM es solo una de sus interfaces. Se puede agrupar, crear más cuadernos, cambiar de herramienta. Lo que no se hace nunca es borrar conocimiento válido para encajar en el menú de precios de un tercero.
Por qué la IA no podría mentir aquí aunque quisiera
Escribimos hace tiempo que una pyme no puede permitirse una IA que maquille la realidad con una respuesta bonita. Nuestro sistema lo resuelve por diseño: si alguien pregunta por algo que no aparece en la documentación curada, la respuesta es "no consta en la documentación disponible, ¿quieres que busque en internet?". Parece un matiz de redacción, pero es la diferencia entre reconocer un límite y afirmar en falso sin ponerse ni medio colorao.
Soberanía real
BIZB trabaja dentro del entorno del cliente. Los originales, la Wiki y las decisiones están allí. La empresa puede auditar lo que hacemos mientras lo hacemos, descargarlo, cambiar de proveedor o pedirnos que salgamos. No nos llevamos su documentación a una plataforma propia para prestar el servicio, y tampoco construimos una copia paralela que nos convierta, sin querer, en sus únicos administradores. Es una arquitectura incómoda para cualquier consultora que quiera generar dependencia. A nosotros nos parece la única honesta.
Hay también una regla que nos incomoda a nosotros mismos siendo a la vez la que más nos importa: si el sistema descubre que una decisión depende solo de lo que sabe BIZB, tiene que señalarlo. Hay que sacarlo de nuestra cabeza, formalizarlo, validarlo, y dejarlo dentro de la empresa. El consultor también tiene que salir del contexto.
Lo que terminamos construyendo
De la capacidad del equipo para preguntar, a la capacidad de la empresa para recordar. Del deseo de que un equipo pueda preguntar a sus documentos, a dotar a la organización
del poder de recuperar su propio conocimiento de forma fiable. ¿De dónde salió esa afirmación, por qué se tomó tal decisión, qué versión estaba vigente? ¿Qué aprendió una persona, y qué aprendió una IA?
Atención al esquema: RAW, WIKI y SCHEMA no saben qué es ChatGPT ni falta que les hace. Las interfaces de consulta son la única pieza de todo el sistema que se puede sustituir sin tocar nada más. Si mañana el cliente prefiere Claude, o Gemini, o lo que exista dentro de tres años, el cerebro sigue igual: se conecta otra interfaz y punto.
Lo planteábamos como pregunta de fondo en el contexto inteligente de tu empresa: la dificultad está en construir precisión de negocio. Este proyecto es el resultado de haber puesto esa idea a trabajar durante meses con un cliente real, y haciéndolo hemos visto con más claridad qué es lo que estábamos construyendo en realidad: un sistema de información empresarial con acceso a la memoria de la empresa, ordenado y gobernado, y que no depende de qué IA la consulte hoy.
Si lo quieres, ya sabes.